

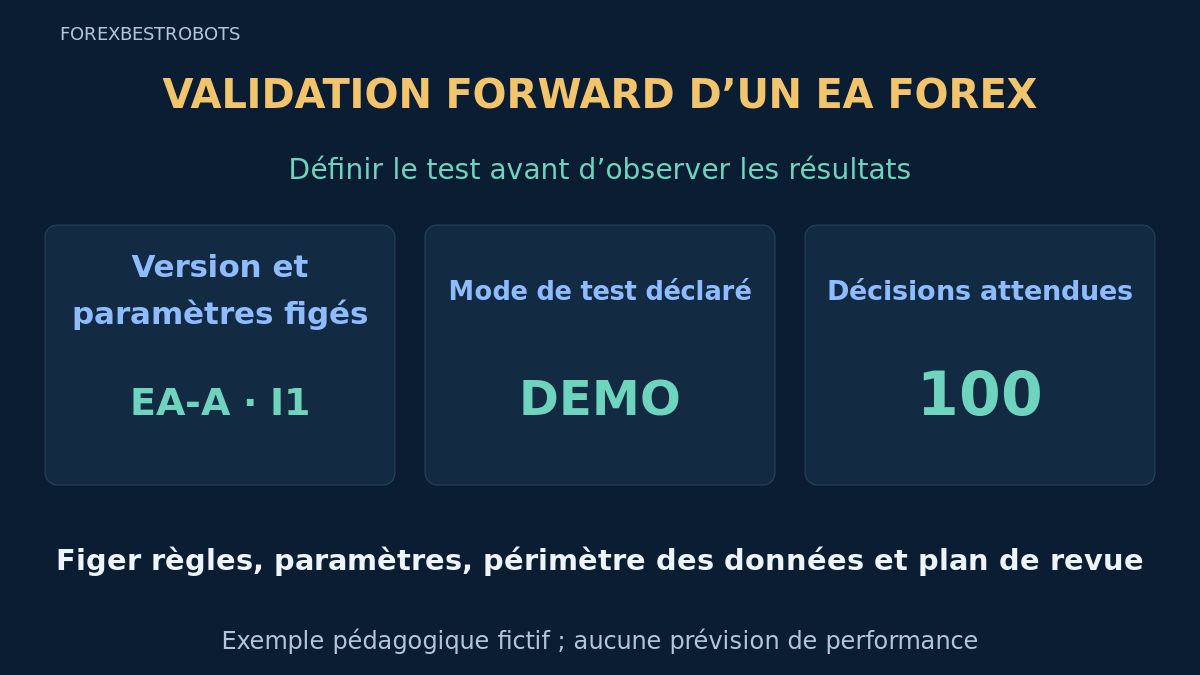
L’observation forward examine le comportement d’un EA fixe sur des données arrivant après le gel du plan. Elle n’est utile que si version, informations disponibles à chaque décision et règles de revue restent traçables. Une période rentable choisie après coup n’est pas la même expérience.
Distinguez préparation opérationnelle, complétude des preuves et évaluation de la performance. Le rapprochement du premier guide établit les faits ; ce guide définit leur observation prospective. Ni un grand livre propre ni un calendrier achevé ne prouve la rentabilité ou n’autorise à financer un compte réel.
1. Écrire la question avant de collecter les résultats
Précisez comportement et environnement évalués : timing des signaux, reproduction des décisions, traitement des demandes, écarts d’exécution ou hypothèse de performance précise. Nommez comparaison et preuves nécessaires. Un solde croissant ne remplace pas ces questions.
Consignez toutes les variantes et tentatives de sélection antérieures, y compris les échecs. Une nouvelle période forward n’efface pas l’historique de sélection. Ajuster sans cesse après consultation des résultats transforme ces observations en développement. Le guide du surajustement explique pourquoi un backtest sélectionné séduisant exige davantage d’examen.
2. Séparer observation sans ordres, démo et réel
Ici, shadow désigne un observateur qui enregistre des décisions sans envoyer d’ordres. Démo signifie des demandes vers un compte simulé du courtier ; réel signifie l’exécution sur un compte financé. Documentez explicitement le mode sans employer forward comme une garantie d’exécution réelle.
| Mode | Ce qu’il peut enregistrer | Principale limite des preuves |
|---|---|---|
| Observateur sans ordres | Décisions et données disponibles ; aucun ordre | Aucune exécution du courtier observée |
| Compte démo | Décisions, demandes simulées et relevés du courtier | Ne prouve ni exécutions ni frais réels |
| Compte réel | Demandes réelles, relevés et effets sur le compte | Capital exposé ; résultats incertains |
L’exemple fictif utilise uniquement la démo et ne recommande aucune allocation réelle. Comparez les modes après avoir aligné versions, données et couverture temporelle, en gardant les relevés distincts. Le guide démo contre réel décrit les écarts ; un observateur ne peut déduire des exécutions réelles d’un graphique Bid.
3. Figer un manifeste identifiant l’expérience
Archivez binaire/version de l’EA et, si disponible, révision du code ; notez empreintes, valeurs et fichier de paramètres. Incluez serveur, compte et mode, devise, correspondance des symboles, unité de temps, dépendances, version du terminal, base horaire, sources, version de politique de risque, début, règle de fin et revues. Un nom de fichier seul n’identifie pas la configuration.
Pour l’exemple, figez EA-A et les paramètres I1 sur une exécution démo EURUSD H1. Le manifeste contient horodatages et identifiants des décisions du calendrier fixe. Les règles de trading et de risque restent inchangées ; ce guide ne fournit ni ces règles ni contrôleur. La sécurité opérationnelle suit la politique de risque du compte existante.
4. Capturer ce qui était réellement disponible à chaque décision
Sauvegardez limite de décision, identifiants des bougies clôturées, cours et variables pertinents, heures source, heures de réception et contrôles de fraîcheur. Utilisez une normalisation documentée. Dans l’exemple, F1 est datée de 09:00:00 mais arrive à 09:00:08, après l’instantané figé à 09:00:05. Elle ne peut alimenter cette décision. La revue à 09:00:10 doit préserver ce fait.
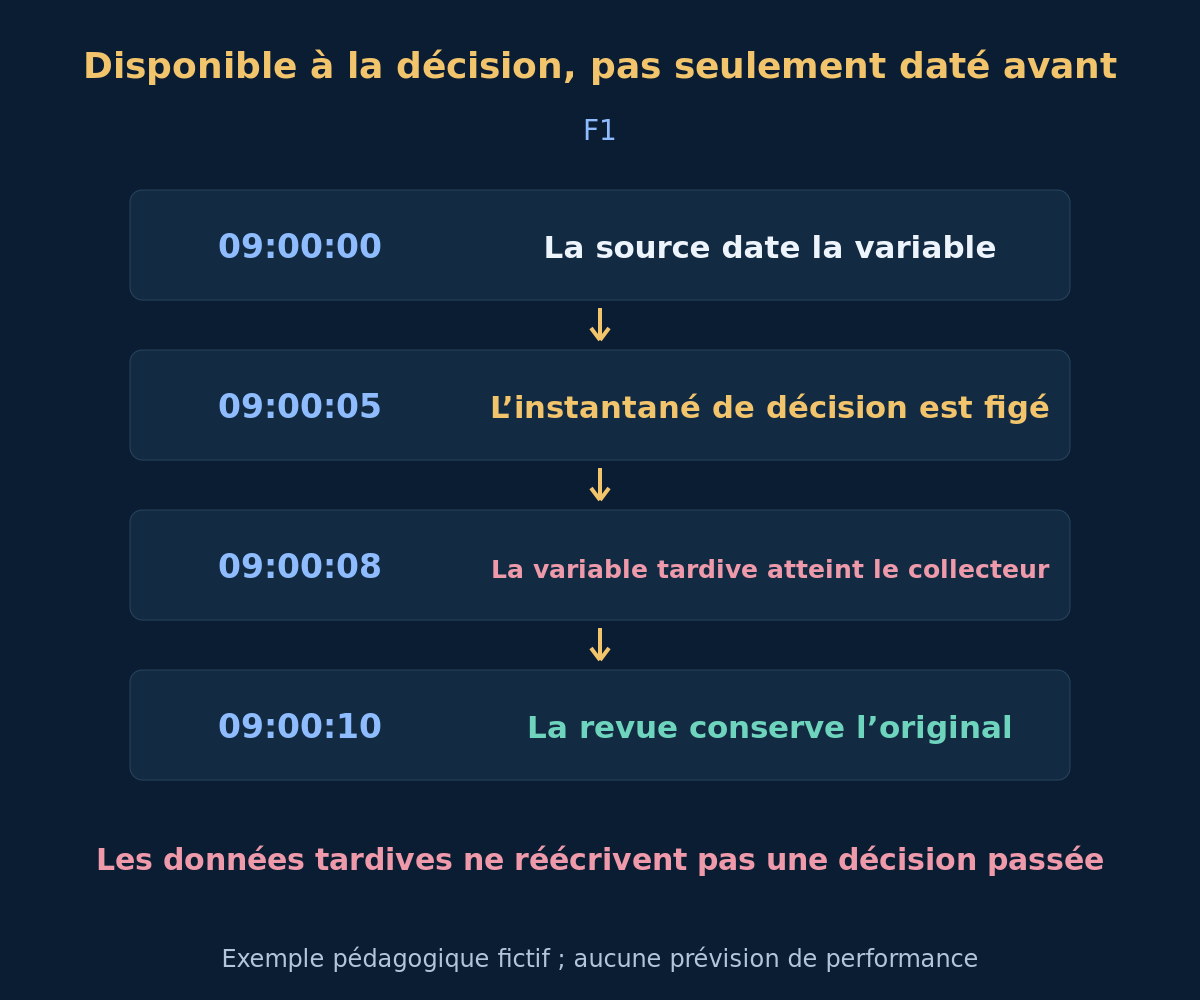
Un horodatage source antérieur ne prouve pas que l’EA pouvait alors lire la valeur. Appliquez la règle figée de données manquantes, y compris une absence d’entrée documentée si nécessaire. Gardez les corrections ultérieures à part. Reconstruire avec historique révisé, bougie alors en formation désormais terminée ou valeur reçue plus tard introduit une information absente de l’exécution initiale.
5. Prédéfinir la fenêtre et les occasions attendues
Fixez début et règle de fin, calendrier de marché, séances permises, décisions attendues, exclusions d’initialisation et revues avant l’observation. Expliquez fermetures, bougies manquantes, redémarrages et pannes. Une panne ne disparaît pas du dénominateur parce qu’aucun ordre n’a été envoyé. Séparez créneaux, signaux, demandes et opérations terminées.
Le calendrier fictif comporte 100 décisions attendues en 4 blocs consécutifs de 25. Examinez chaque fin de bloc et terminez après le dernier créneau. Ces nombres rendent l’audit reproductible ; ce ne sont ni minimum recommandé ni calcul de puissance statistique. Durée et preuves réelles dépendent de fréquence, dépendance, conditions de marché et question étudiée.
6. Prédéfinir revues, interruptions et changements
Séparez exigences de qualité des sources, escalade opérationnelle et critères de performance. Définissez métriques, attribution, frais, flux externes, positions ouvertes et tolérances avant les résultats. Les guides capitaux propres et drawdown et coûts apportent un contexte comptable, pas des seuils universels.
Dans cette démo, chaque décision attendue exige une preuve traçable avant validation du dossier de performance. Un créneau non résolu laisse cette validation en suspens. Les revues planifiées ne retardent pas les mesures urgentes de la politique de risque existante. Ne prolongez pas jusqu’au gain, n’arrêtez pas au sommet favorable et ne changez pas discrètement un seuil après une perte.
7. Auditer l’exemple fictif de couverture
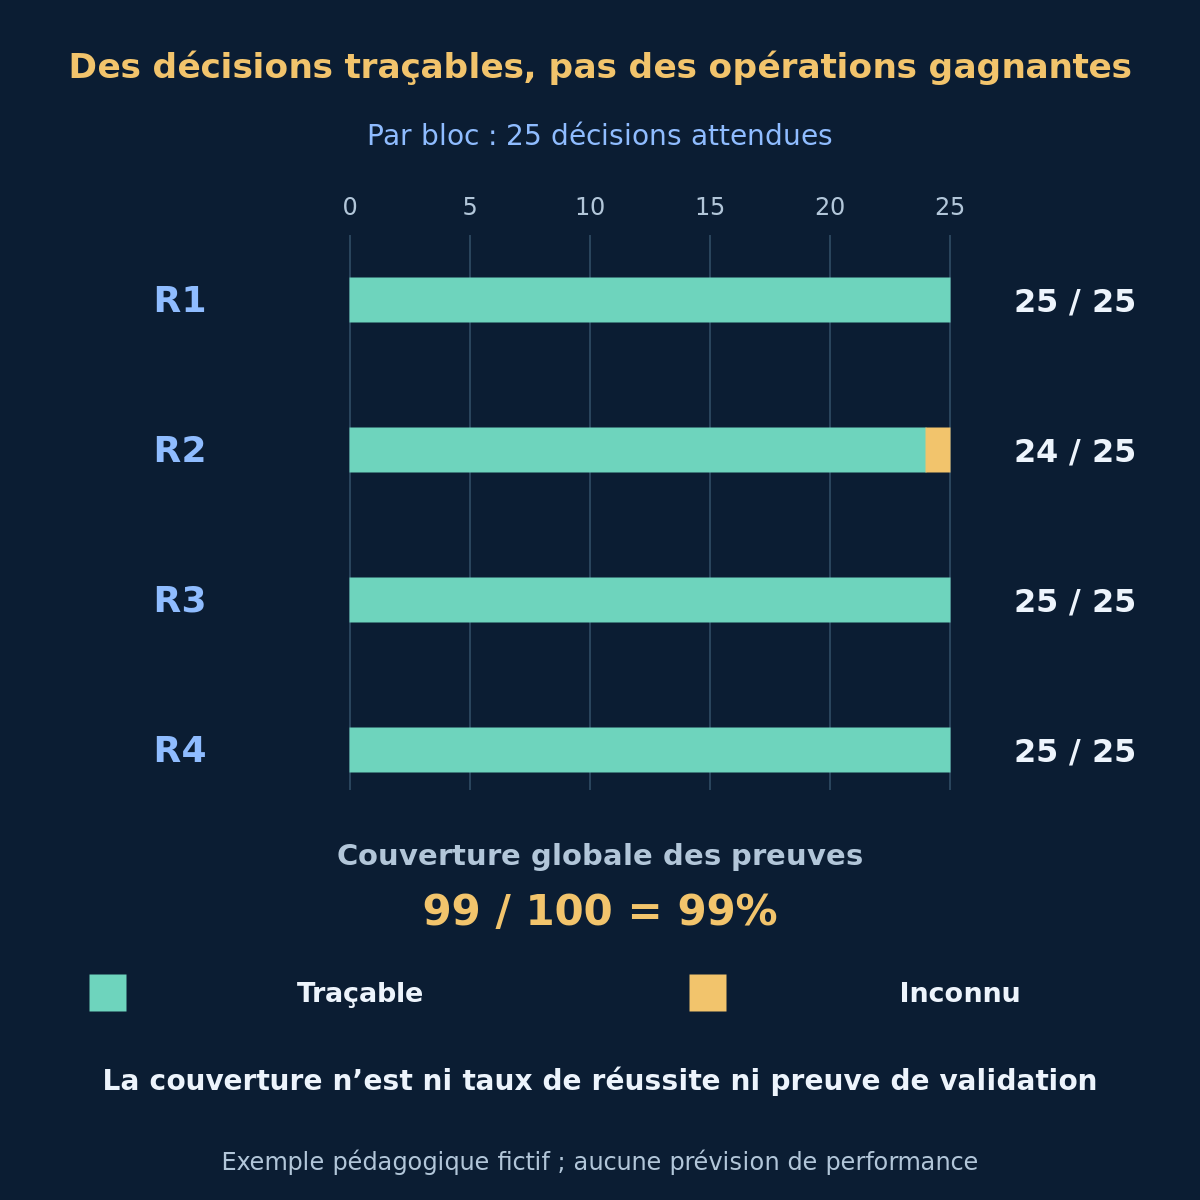
Le tableau présente des blocs disjoints, pas des cumuls. Une décision traçable conserve les données disponibles à l’instant et un résultat consigné, y compris absence de signal ou abstention documentée ; un créneau inconnu manque de preuves suffisantes. R2 contient une décision manquante encore non résolue à la fin. N’en déduisez pas l’absence de signal, demande ou exposition.
| Bloc de revue | Décisions attendues | Décisions traçables | Créneaux inconnus | Couverture des preuves |
|---|---|---|---|---|
| R1 | 25 | 25 | 0 | 100% |
| R2 | 25 | 24 | 1 | 96% |
| R3 | 25 | 25 | 0 | 100% |
| R4 | 25 | 25 | 0 | 100% |
Au total, 99 décisions sur 100 sont traçables et 1 inconnue : couverture 99%. Les blocs complets ultérieurs ne réparent pas la lacune antérieure. Selon la règle prédéfinie de complétude, le dossier reste non concluant. Le calcul ne mesure pas le taux de réussite et ne dit pas que la stratégie a échoué ; même des relevés complets exigeraient une évaluation distincte de suffisance et de performance.
Facultatif : reproduire les décomptes et la couverture
Créneaux attendus : 25 + 25 + 25 + 25 = 100. Décisions traçables : 25 + 24 + 25 + 25 = 99. Inconnus : 0 + 1 + 0 + 0 = 1. Bloc complet : 25 / 25 × 100 = 100%. Bloc incomplet : 24 / 25 × 100 = 96%. Couverture globale : 99 / 100 × 100 = 99%. Part inconnue : 1 / 100 × 100 = 1%. Contrôle : 99 + 1 = 100. Les pourcentages ne décrivent que les preuves ; notation numérique anglaise conservée.
8. Traiter les règles modifiées comme une nouvelle exécution
Changer seuil, paramètres, univers de symboles, filtre de séance ou règle de risque change l’expérience. Notez motif et heure d’effet, préservez l’ancien et démarrez une version identifiée. EA-B avec I2 ne doit pas être ajouté à EA-A avec I1 comme si rien n’avait changé. Les changements d’infrastructure exigent aussi une trace datée et une analyse de comparabilité.
Une correction peut être nécessaire sans rendre inédites des observations déjà consultées. Gardez l’incident et la période affectée ; obtenez des preuves ultérieures sous le nouveau protocole. Déclarez variantes et consultations antérieures. N’effacez pas une mauvaise exécution, ne regroupez pas des résultats incompatibles et ne présentez pas une relecture rétrospective comme observation forward originale.
9. Respecter les limites du testeur historique et de la plateforme
Tests historiques et observation forward répondent à des questions distinctes. MT4 documente ses limites : des fonctions externes telles que WebRequest() et SendNotification() ne s’exécutent pas dans Strategy Tester, et les opérations sur d’autres symboles que celui testé ne sont pas réalisées. Un passage historique ne prouve pas le fonctionnement des données et alertes en réel.
Consultez le guide du backtesting pour les hypothèses du modèle et des données, et le guide du suivi pour les parcours opérationnels. Vérifiez la disponibilité des données intersymboles séparément de l’exécution. Réception, déconnexion, reprise et protection doivent être attestées dans un environnement observé adapté, pas supposées identiques au testeur.
10. Rédiger une conclusion limitée lors de la revue prévue
Rapportez identité du protocole, mode, dates réelles, couverture attendue et observée, incidents, changements, éléments non résolus et métriques prédéfinies avec leurs limites. Incluez pertes et exposition ouverte, pas seulement les clôtures favorables. La statistique doit tenir compte de dépendance et sélection répétée ; cet exemple ne calcule ni significativité ni probabilité de surajustement.
- Manifeste, comparaison, fenêtre et règles ont-ils été figés avant les résultats ?
- Chaque décision a-t-elle utilisé seulement l’information réellement disponible à son arrêté ?
- Les relevés shadow, démo et réels sont-ils séparés ?
- Lacunes, incidents, frais, positions ouvertes et changements sont-ils visibles ?
- La conclusion suit-elle les critères initiaux sans assimiler couverture et rentabilité ?
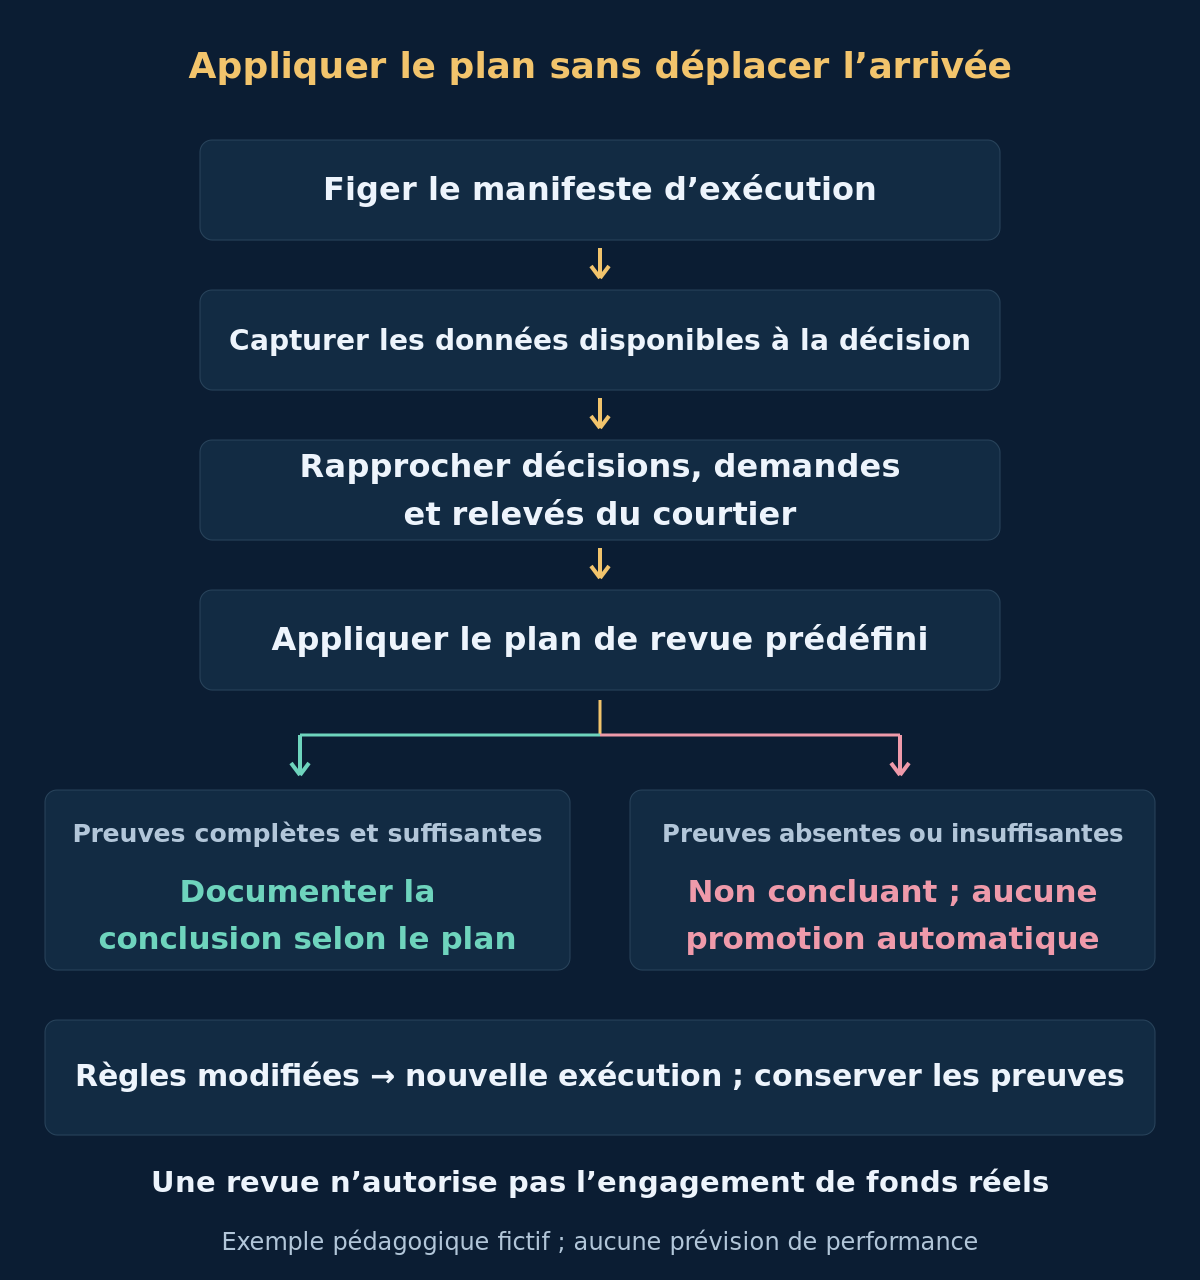
Concluez précisément : preuves incomplètes, complètes mais insuffisantes pour la question, ou résultat documenté selon l’évaluation prédéfinie. Aucun cas ne fait automatiquement passer un EA démo à des fonds réels. Déploiement ou allocation ultérieurs exigent décision autorisée et contrôles propres. Conservez le dossier pour le suivi et la revalidation.
11. Questions sur la validation forward
Forward signifie-t-il trader avec de l’argent réel ?
Non. Précisez shadow, démo ou réel. Seul le réel enregistre l’exécution d’un compte effectivement financé et expose le capital à la perte.
Les 100 décisions suffisent-elles pour valider un EA ?
Ce n’est pas affirmé. Ce sont des données fictives de couverture, pas une recommandation de taille. Les décisions ne sont pas forcément opérations ou observations indépendantes ; une couverture complète ne prouve pas un avantage.
Puis-je améliorer les paramètres et garder le même résultat forward ?
Gardez l’ancien résultat, mais identifiez le changement comme nouvelle exécution/version. Les observations utilisées pour choisir les paramètres sont du développement, pas une validation inédite de ce choix.
Une couverture de 99% signifie-t-elle 99% de réussite ?
Non. Elle indique la part des créneaux de décision avec preuve traçable. Dans cet exemple, la lacune non résolue bloque la validation des preuves prévue, quel que soit le résultat de trading.
12. Sources et portée
Sources primaires : fonctionnement et limites de MQL4 Strategy Tester, configuration du testeur et paramètres MetaTrader, et Bailey et coauteurs, The Probability of Backtest Overfitting. Vérifiées le 2026-10-18. La recherche motive la prudence face à la sélection ; elle ne certifie ni protocole ni décomptes de l’exemple.
Noms, heures des variables, calendrier et décomptes sont des éléments pédagogiques fictifs. Aucune stratégie réelle, performance live, taille minimale, espérance de rendement ou recommandation de financement n’est fournie. Les diagrammes montrent protocole et preuves, pas des rapports originaux du testeur. Un plan figé améliore la traçabilité sans garantir un trading rentable ou sûr.